Campione ed errore campionario: quante persone bastano
In breve. La domanda sembra insensata: come fanno mille persone a rappresentare sessanta milioni? Eppure la matematica del campionamento dice che per stimare una proporzione con un margine di ±3% al livello di confidenza del 95% servono circa 1.068 persone — e questo numero non cambia quasi per niente se la popolazione è un paese di ventimila abitanti o l’Italia intera. Il margine dipende da quante persone intervisti, non da quante ce ne sono. Da qui discendono tre cose che quasi nessuno ha in mente: dimezzare il margine costa quattro volte il campione; per i gruppi piccoli vale la regola opposta; e il margine d’errore copre solo il caso in cui hai estratto le persone davvero a caso, non tutto il resto che può andare storto.
Ogni volta che esce un sondaggio, torna la stessa obiezione da bar: «hanno sentito mille persone, cosa vuoi che significhi». È un’intuizione ragionevole e sbagliata, e capire perché è sbagliata è uno degli esercizi più utili di alfabetizzazione statistica. La risposta sta in una sola formula e in un fatto controintuitivo che ne deriva.
La regola che tutti citano e nessuno spiega
Partiamo dal numero che gira: mille intervistati, margine di circa ±3 punti. È vero, ed è il motivo per cui quasi tutti i sondaggi politici italiani usano campioni di quell’ordine. Ma «±3%» non è un marchio di qualità né una convenzione: è il risultato di un calcolo. Ecco quanto vale il margine al crescere del campione.
| Persone intervistate (n) | Margine d’errore al 95% |
|---|---|
| 100 | ±9,8% |
| 400 | ±4,9% |
| 600 | ±4,0% |
| 1.000 | ±3,1% |
| 2.401 | ±2,0% |
| 5.000 | ±1,4% |
| 10.000 | ±1,0% |
Margine d’errore = metà dell’ampiezza dell’intervallo di confidenza, calcolato al 95% nel caso peggiore (vedi sotto). Elaborazione Metron Journal; ogni valore è ricalcolato nello [script scaricabile in fondo]. Serie completa da 50 a 10.000 nel CSV.
Due cose saltano subito all’occhio. La prima: la colonna di destra non scende in proporzione a quella di sinistra. Da 100 a 400 persone (quattro volte tanto) il margine si dimezza, da ±9,8% a ±4,9%. Da 400 a 1.600 dovresti quadruplicare di nuovo per dimezzarlo ancora. La seconda: dopo qualche migliaio di interviste, aggiungerne altre serve a pochissimo. È la firma di una curva a rendimenti decrescenti, e ha una spiegazione precisa.
Da dove viene il numero
Quando stimi una proporzione — la quota di chi voterebbe un partito, di chi ha usato un servizio, di chi è d’accordo con un’affermazione — l’incertezza della stima si misura con una formula sola:
margine = z · √( p·(1−p) / n )
Dove n è il numero di persone intervistate, p è la proporzione che stai stimando, e z è un coefficiente che dipende dal livello di confidenza (per il 95%, lo standard, vale 1,96). Il resto è tutto lì dentro.
Il pezzo importante è quel n sotto la radice quadrata. È la ragione dei rendimenti decrescenti: per dimezzare il margine devi dividere per quattro il contenuto della radice, cioè quadruplicare il campione. Non è un dettaglio tecnico, è la legge economica del sondaggio: la precisione si paga a un prezzo che sale sempre più ripido.
Un’avvertenza, perché il numero non venga preso per più di quello che è: questa formula è l’approssimazione normale (in gergo, l’intervallo di Wald), non un’identità esatta. Funziona bene quando il campione non è piccolissimo e la proporzione non è troppo vicina a 0 o a 100%; agli estremi la copertura reale si scosta dal 95% ed esistono formule più accurate. E il p vero non si conosce mai: nel calcolo si usa la proporzione stimata dal sondaggio, oppure — per il margine da dichiarare prima di sapere il risultato — il caso peggiore p = 0,5.
Poi c’è p·(1−p), che è massimo quando p = 0,5: metà e metà è la situazione di massima incertezza. Per questo i margini dichiarati usano quasi sempre p = 0,5, il caso peggiore: garantisce che il margine reale non sarà mai più largo di quello annunciato. Se la quota da stimare è lontana dalla metà, il margine si stringe da solo. Con mille interviste, un partito dato al 10% ha un margine di ±1,86%, non di ±3,1%; al 5%, di ±1,35%. Il ±3% è la promessa più prudente, non la misura di ogni singola percentuale del sondaggio.
Quante persone servono, allora
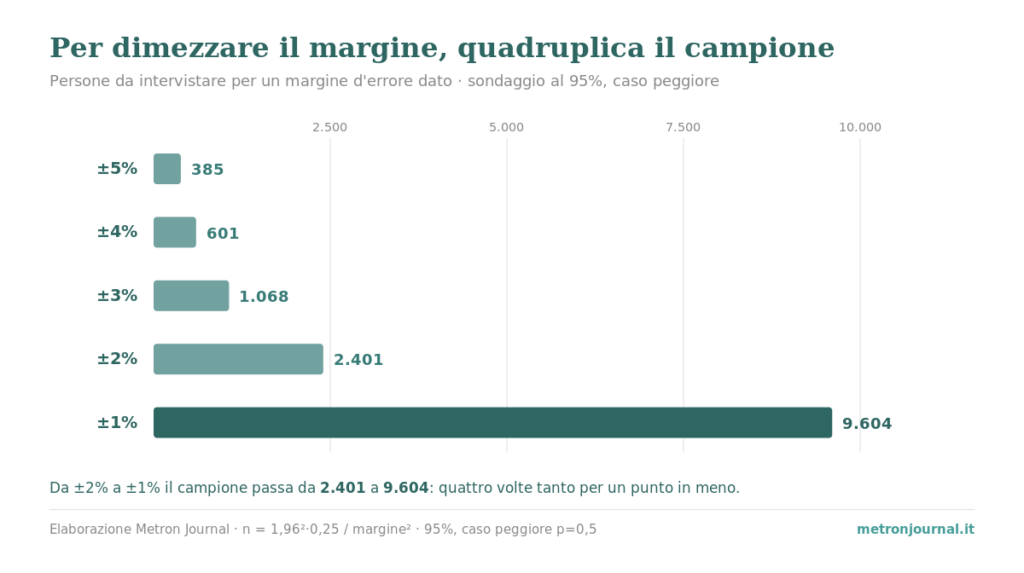
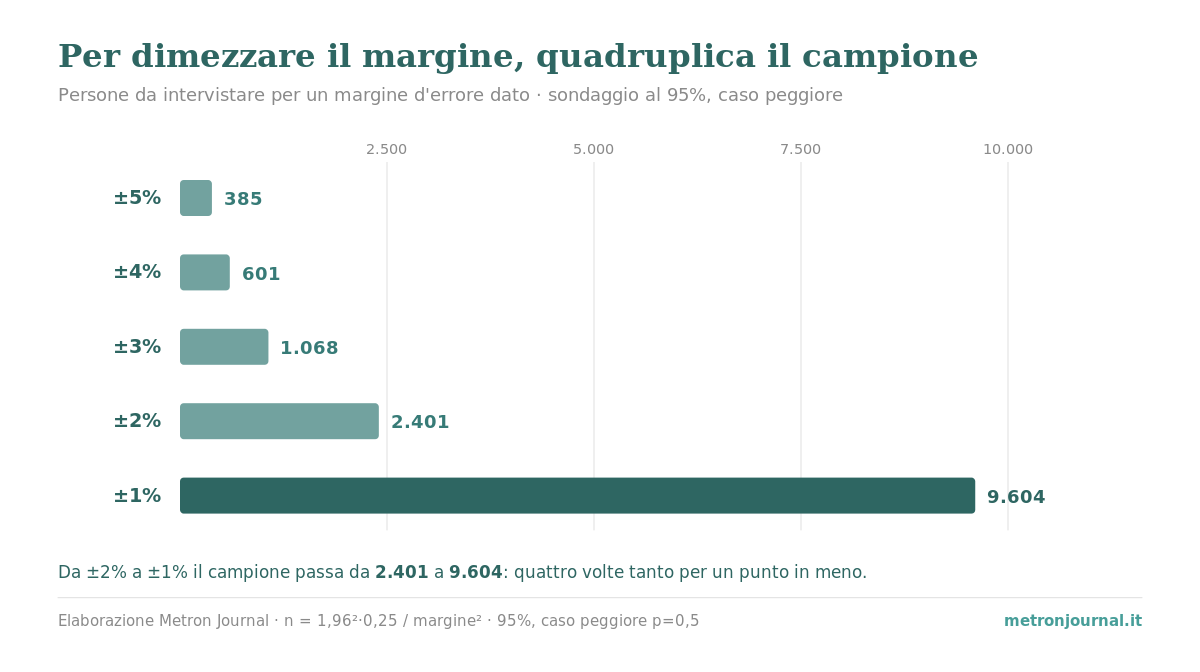
Rovesciamo la formula: fissato il margine che vuoi, quante persone ti servono? Basta isolare n, e nel caso peggiore (p = 0,5) il conto diventa n = 1,96²·0,25 / margine².
| Margine d’errore voluto | Persone da intervistare |
|---|---|
| ±5% | 385 |
| ±4% | 601 |
| ±3% | 1.068 |
| ±2% | 2.401 |
| ±1% | 9.604 |
Numerosità minima per una popolazione grande, livello di confidenza 95%, caso peggiore p = 0,5. Valori arrotondati per eccesso. Elaborazione Metron Journal.
Qui la legge dei rendimenti decrescenti si vede in tutta la sua durezza. Passare da un margine di ±2% a uno di ±1% — un solo punto in meno — richiede di salire da 2.401 a 9.604 interviste: quattro volte il campione per dimezzare l’errore. È il motivo per cui i sondaggi si fermano quasi tutti tra le 1.000 e le 2.000 interviste: sotto conviene, sopra il costo esplode e il guadagno di precisione è minimo.
La sorpresa: la popolazione non c’entra quasi niente
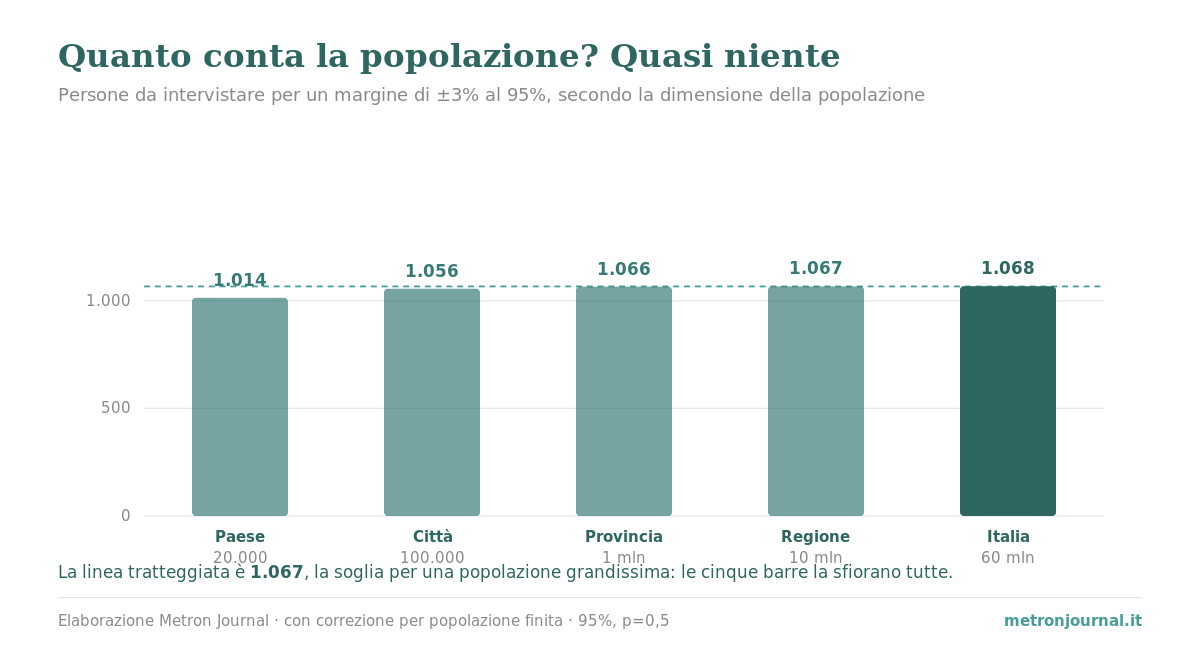
Ecco il punto che rovescia l’intuizione da bar. In tutte le formule qui sopra non compare la dimensione della popolazione. Non è una dimenticanza: finché la popolazione è grande, il margine dipende solo dal campione. Per un margine di ±3%, ecco quante persone servono davvero a seconda di quanto è grande il gruppo che vuoi studiare.
| Popolazione | Persone da intervistare per ±3% |
|---|---|
| 20.000 (un paese) | 1.014 |
| 100.000 (una città) | 1.056 |
| 1.000.000 (una provincia) | 1.066 |
| 60.000.000 (l’Italia) | 1.068 |
Con correzione per popolazione finita, 95%, caso peggiore. Elaborazione Metron Journal.
Un paese di ventimila abitanti e l’Italia intera richiedono quasi lo stesso numero di interviste: poco più di mille in entrambi i casi. La differenza fra 1.014 e 1.068 è tutta la «correzione per popolazione finita», e diventa trascurabile appena la popolazione supera qualche decina di migliaia. Il campione è un assaggio: per sapere se una pentola di minestra è salata basta un cucchiaio, che la pentola sia grande o piccola — a patto di aver mescolato bene. È l’immagine giusta, e «aver mescolato bene» è la parte che conta più di tutte, e su cui torniamo alla fine.
Quando invece la popolazione conta: i gruppi piccoli
La regola si capovolge quando il gruppo da studiare è piccolo. Se vuoi intervistare i dipendenti di un’azienda di 500 persone con un margine di ±5%, la formula da popolazione grande direbbe 385, ma correggendo per la popolazione finita ne bastano 218 — il 44% del totale. E se pretendi ±3% da quelle stesse 500 persone, te ne servono 341, cioè più di due terzi: quasi un censimento. Qui il campionamento smette di convenire, e tanto vale intervistare tutti.
Questa è la vera ragione per cui la dimensione della popolazione «sparisce» dalle formule dei sondaggi nazionali: 60 milioni è così grande rispetto a mille che la correzione è invisibile. Ma su un condominio, una classe, un reparto, un piccolo comune, la correzione è la parte più importante del conto.
Allora perché ISTAT intervista 250.000 famiglie?
Se mille persone bastano per l’Italia con un margine del 3%, come mai le grandi indagini pubbliche ne sentono molte di più? La Rilevazione sulle forze di lavoro dell’ISTAT — quella da cui esce il tasso di disoccupazione — intervista circa 250.000 famiglie all’anno (62.000 a trimestre, circa 600.000 persone) in circa 1.100 comuni. L’indagine EU-SILC su reddito e condizioni di vita, la fonte dei dati sulla povertà e sulla disuguaglianza, nel 2024 ha coinvolto 31.790 famiglie. Numeri enormi rispetto ai mille di un sondaggio. Contraddizione?
No: è che quelle indagini non devono stimare un numero per l’Italia, ma centinaia di numeri per centinaia di sottogruppi. Il tasso di disoccupazione non serve solo nazionale: serve per ogni regione, per ogni provincia, per uomini e donne, per fasce d’età, per titolo di studio. E ogni sottogruppo è, di fatto, un campione a sé, che ha bisogno della propria numerosità per avere un margine accettabile. Se vuoi un dato affidabile sulla disoccupazione giovanile in Molise, i mille italiani «medi» non bastano: di molisani giovani, dentro quei mille, ce ne sarebbero una manciata. La numerosità gigantesca serve al dettaglio, non alla media nazionale — che con mille interviste sarebbe già stimata benissimo.
Cosa il margine d’errore non copre
Qui arriva la parte che i titoli dimenticano. Il margine d’errore misura una sola fonte di incertezza: quella dovuta al fatto di aver intervistato un campione invece di tutti. È l’errore di campionamento, e la formula lo descrive bene — a una condizione: che il campione sia probabilistico, cioè che ogni persona abbia una probabilità nota e diversa da zero di finirci. La formula semplice qui sopra assume anche che quella probabilità sia uguale per tutti (il campionamento casuale semplice); i disegni reali usano probabilità diverse e restano validi, a patto di correggere con i pesi giusti. Ciò che manda tutto all’aria è il campione non probabilistico — raccolto dove capita, senza una regola di estrazione nota — e nella realtà è la falla più comune.
Tre avvertenze, perché il ±3% non diventi un lasciapassare:
- Il disegno reale non è mai un campione casuale semplice. Le indagini serie non estraggono le persone una per una: le raggruppano in grappoli (per esempio più famiglie nello stesso comune) e stratificano la popolazione in gruppi omogenei. Le due cose tirano in direzioni opposte — il campionamento a grappoli tende ad allargare il margine rispetto alla formula ideale, la stratificazione tende a stringerlo — e l’effetto netto si misura con un fattore detto design effect, che nelle indagini sul campo è quasi sempre maggiore di 1 perché a pesare di più è il grappolo. Con un design effect di 1,5 — un valore realistico — un campione di mille persone ha in pratica un margine di ±3,8%, non ±3,1%, come se le persone davvero indipendenti fossero 667 invece di 1.000.
- Gli errori non campionari non stanno nel margine. Chi non risponde, chi mente, una domanda formulata male, un campione raccolto dove capita invece che a caso: nessuno di questi entra nella formula, e nessuno si riduce aumentando n. Un sondaggio online autoselezionato da centomila persone può essere molto meno affidabile di uno da mille fatto bene, perché ha un margine d’errore piccolo su un campione distorto — e la distorsione, a differenza del margine, non si vede nel numero.
- Il margine è un intervallo, non un punto. Un partito dato al 31% con margine ±3% ha un intervallo di confidenza al 95% che va dal 28% al 34%. Attenzione a cosa significa quel «95%»: non è la probabilità che il valore vero stia dentro questo intervallo — il valore vero è fisso, è l’intervallo a cambiare da campione a campione — ma il fatto che intervalli costruiti così contengono il valore vero nel 95% dei campioni possibili. In pratica: due sondaggi che si «contraddicono» a distanza di un punto stanno spesso dicendo la stessa cosa dentro il rumore. Su come leggere questo intervallo senza cadere nella trappola della sovrapposizione abbiamo scritto una pagina apposta.
La lezione è quella di sempre su questo sito: un numero da solo — anche un margine d’errore — non dice se il dato è buono. Dice quanto sarebbe incerto se tutto il resto fosse fatto a regola d’arte. È una condizione, non una garanzia.
Su questo sito: perché un sondaggio ha un margine e come si legge l’intervallo lo spiega Intervallo di confidenza; da dove nasce l’errore standard che sta dietro la formula lo trovi in Deviazione standard; e quando invece di una proporzione si stima una media, vale Media, mediana e moda. E perché la dimensione del campione riguarda la potenza, non l’affidabilità di un test positivo, lo spiega falsi positivi.
Domande frequenti
Bastano davvero mille persone per un sondaggio nazionale?
Sì, per stimare una proporzione a livello nazionale con un margine di circa ±3% al 95% di confidenza servono poco più di mille interviste (1.068 nel caso peggiore). Il margine dipende da quante persone intervisti, non da quante ne conta la popolazione: per questo un paese di ventimila abitanti e l’Italia intera richiedono quasi lo stesso campione. Vale però solo se le persone sono estratte a caso e se si guarda alla stima nazionale, non ai singoli sottogruppi.
Come si calcola l’errore campionario di un sondaggio?
Per una proporzione, il margine d’errore al 95% è *1,96·√(p(1−p)/n)*, dove *n* è il numero di intervistati e *p* la proporzione stimata. Nel caso peggiore si usa p = 0,5, che rende il margine il più ampio possibile. Con n = 1.000 il margine vale ±3,1%; con n = 400 sale a ±4,9%; con n = 2.401 scende a ±2,0%.
Quante persone servono per dimezzare il margine d’errore?
Quattro volte tante. Poiché nella formula il campione sta sotto radice quadrata, per dimezzare il margine bisogna quadruplicare *n*. Passare da ±2% a ±1% richiede di salire da 2.401 a 9.604 interviste. È la ragione per cui quasi tutti i sondaggi si fermano tra le mille e le duemila interviste: oltre, il costo cresce molto più in fretta della precisione.
Perché l’ISTAT intervista centinaia di migliaia di persone se ne bastano mille?
Perché non deve stimare un solo numero nazionale, ma centinaia di numeri per regioni, province, sessi, età e titoli di studio. Ogni sottogruppo è di fatto un campione a sé e ha bisogno della propria numerosità. La Rilevazione sulle forze di lavoro intervista circa 250.000 famiglie l’anno proprio per garantire il dettaglio territoriale, non per migliorare la media nazionale, che con mille interviste sarebbe già stimata bene.
Un sondaggio con margine ±3% è affidabile?
Il margine d’errore misura solo l’incertezza dovuta al campionamento, e solo se il campione è probabilistico (con probabilità di estrazione note). Non copre chi non risponde, le domande mal formulate, i campioni autoselezionati o il *design effect*, che può allargare il margine reale (con n = 1.000 e un design effect di 1,5 diventa ±3,8%). Un margine piccolo su un campione distorto è una precisione illusoria: dice quanto sarebbe incerto il dato se tutto il resto fosse fatto bene, non che lo sia.
Fonti
- ISTAT, Rilevazione sulle forze di lavoro — Informazioni generali. Numerosità campionaria (~250.000 famiglie l’anno, 62.000 a trimestre, ~600.000 individui, ~1.100 comuni). istat.it/it/archivio/253072 · scheda della rilevazione: istat.it/statistiche-per-temi/focus/rilevazione-sulle-forze-di-lavoro/
- ISTAT, Indagine sul reddito e le condizioni di vita (EU-SILC). Pagina della rilevazione; numerosità campionaria 2024 (31.790 famiglie) dal report ufficiale «Condizioni di vita e reddito delle famiglie». istat.it/informazioni-sulla-rilevazione/eu-silc/ · report (PDF)
- ISTAT, «La rilevazione sulle forze di lavoro: contenuti, metodologie, organizzazione» (metodi e norme n. 32), per il disegno campionario a due stadi. istat.it (PDF)
- Elaborazione Metron Journal. Tutti i valori di margine e numerosità sono calcolati da margine = 1,96·√(p(1−p)/n) e dalla correzione per popolazione finita, nello script
dati_campione_errore.py. Serie completa scaricabile in CSV.
Falsi positivi: perché un test affidabile al 99% può ingannare