Significatività statistica e p-value: cosa non dicono
In breve. Il p-value è una delle misure più usate e più fraintese della scienza. Non dice la probabilità che un’ipotesi sia vera, non misura quanto è grande o importante un effetto, e la soglia dello 0,05 è una convenzione, non una legge di natura. Un risultato «statisticamente significativo» può benissimo essere un falso allarme: se l’ipotesi di partenza era poco plausibile, anche con un p sotto 0,05 la maggioranza dei risultati significativi può essere falsa. Ecco cosa misura davvero il p-value, cosa non misura, e come leggerlo senza cadere nelle trappole che l’American Statistical Association ha messo nero su bianco.
«Lo studio ha trovato un effetto statisticamente significativo.» È una delle frasi più abusate del giornalismo scientifico, e quasi sempre viene letta come se dicesse «l’effetto è reale e conta». Non è quello che significa. La significatività statistica è un concetto tecnico, preciso e più modesto di quanto sembri — e nel 2016 l’American Statistical Association, la più grande associazione di statistici del mondo, ha sentito il bisogno di pubblicare un comunicato ufficiale per spiegare, punto per punto, cosa un p-value non dice. Questo magazine porta il nome di Corrado Gini, lo statistico che fondò Metron nel 1920: qui il rigore su cosa misura davvero un numero è il punto di partenza.
Che cos’è un p-value, detto per bene
Immagina di lanciare una moneta venti volte e ottenere sedici teste. Ti chiedi: la moneta è truccata? Il metodo classico parte dall’ipotesi opposta — l’ipotesi nulla: la moneta è regolare, testa e croce hanno la stessa probabilità. Poi calcola una cosa sola: se la moneta fosse davvero regolare, quanto sarebbe raro un risultato estremo come questo (o più estremo)? Quella probabilità è il p-value.
La definizione ufficiale, nelle parole dell’American Statistical Association, è questa: il p-value è la probabilità, sotto uno specifico modello statistico (l’ipotesi nulla), che un riassunto dei dati — per esempio la differenza tra due gruppi — sia uguale o più estremo del valore osservato. Tutto qui. È una misura di compatibilità tra i dati e l’ipotesi nulla: più il p-value è piccolo, più i dati sono «sorprendenti» se l’ipotesi nulla fosse vera.
Il punto cruciale sta in quel se. Il p-value si calcola dando per scontato che l’ipotesi nulla sia vera. Non può quindi, per costruzione, dirti la probabilità che l’ipotesi nulla sia vera: quella l’ha già assunta come punto di partenza. È l’errore logico più comune, e ci torniamo tra un attimo.
La soglia dello 0,05 è una convenzione, non una legge
Da dove viene il fatidico «p < 0,05»? Da una scelta pratica dello statistico Ronald Fisher negli anni Venti del Novecento, che propose lo 0,05 (un risultato su venti) come soglia comoda oltre la quale valeva la pena guardare con attenzione. Comoda: non magica. Non c’è niente nella matematica che renda 0,05 diverso da 0,04 o da 0,06.
E c’è un fatto che rende evidente l’arbitrarietà. Se l’ipotesi nulla è vera — cioè se non c’è nessun effetto — il p-value non tende a un valore particolare: si distribuisce in modo uniforme tra 0 e 1 (per un test con statistica continua). Vuol dire che, quando non c’è niente da trovare, un p-value sotto 0,05 esce comunque il 5% delle volte, uno sotto 0,01 l’1% delle volte, uno sotto 0,10 il 10% delle volte: esattamente per costruzione. La soglia non separa il vero dal falso; fissa solo quanto spesso sei disposto a dare un falso allarme quando non c’è niente.
L’errore logico che fa quasi tutti
Ecco la confusione da smontare, perché è alla radice di quasi tutte le altre. Un p-value di 0,03 non vuol dire «c’è il 3% di probabilità che il risultato sia dovuto al caso» né «c’è il 97% di probabilità che l’effetto sia reale». Sono due frasi che si leggono ovunque, e sono entrambe sbagliate.
La ragione è quella di prima: il p-value risponde alla domanda «quanto sono compatibili i dati con l’ipotesi nulla?», non alla domanda «quanto è probabile l’ipotesi nulla dati i risultati?». Sono due probabilità diverse, e scambiarle è come confondere «la probabilità che il cielo sia nuvoloso dato che piove» (altissima) con «la probabilità che piova dato che è nuvoloso» (molto più bassa). Invertire il condizionamento cambia completamente il risultato.
Per sapere quanto è probabile che un’ipotesi sia vera dopo aver visto i dati serve un ingrediente in più, che il p-value da solo non contiene: quanto era plausibile l’ipotesi prima. Ed è qui che le cose si fanno interessanti.
Perché un risultato «significativo» può essere falso
Mettiamo insieme tre numeri: quanto è plausibile l’ipotesi prima dell’esperimento (il base rate, o prior), la potenza del test (la probabilità di accorgersi di un effetto vero, quando c’è) e il livello di significatività α (la probabilità di un falso allarme quando l’effetto non c’è, di solito 0,05). Con questi tre — e solo con questi tre — si può calcolare una quota utile: in un insieme di test con quelle caratteristiche, che frazione dei risultati significativi corrisponde a un effetto reale? In gergo è il valore predittivo positivo. Attenzione: è una proprietà dell’insieme dei test, sotto le ipotesi del modello (prior noto, potenza fissa, test indipendenti, nessun errore sistematico), non un numero che si possa leggere dal p-value di un singolo studio. Serve a capire come base rate e potenza spostano il quadro, non a dare la «probabilità che questo studio abbia ragione».
Facciamo il conto su un caso concreto. Un laboratorio testa 1.000 ipotesi, di cui una su dieci è davvero vera (prior 10%). Il test ha una potenza dell’80% e un livello di significatività del 5%.
| Su 1.000 ipotesi testate | Numero |
|---|---|
| Ipotesi vere (10%) | 100 |
| Ipotesi nulle (nessun effetto) | 900 |
| Scoperte vere (80% delle 100 vere) | 80 |
| Falsi allarmi (5% delle 900 nulle) | 45 |
| Risultati «significativi» totali | 125 |
| Di cui veri | 80 su 125 = 64% |
Elaborazione Metron Journal; conti in dati_pvalue.py. Modello illustrativo con test indipendenti e nessun errore sistematico.
Il risultato è controintuitivo: più di un terzo dei risultati «significativi» — 45 su 125 — sono falsi allarmi, pur avendo usato la soglia dello 0,05 e un test tutt’altro che debole. E il numero peggiora rapidamente man mano che l’ipotesi di partenza diventa meno plausibile.
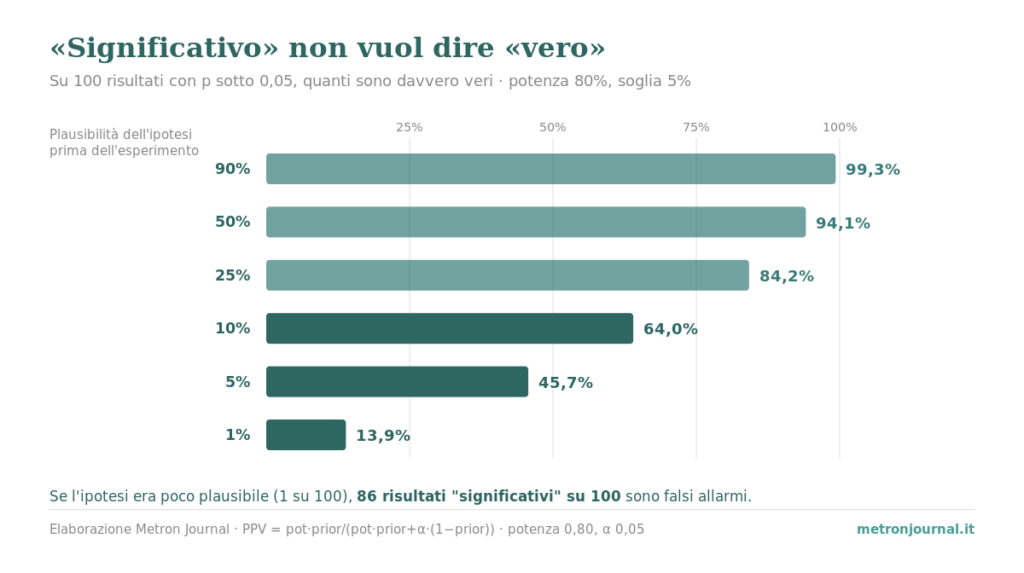
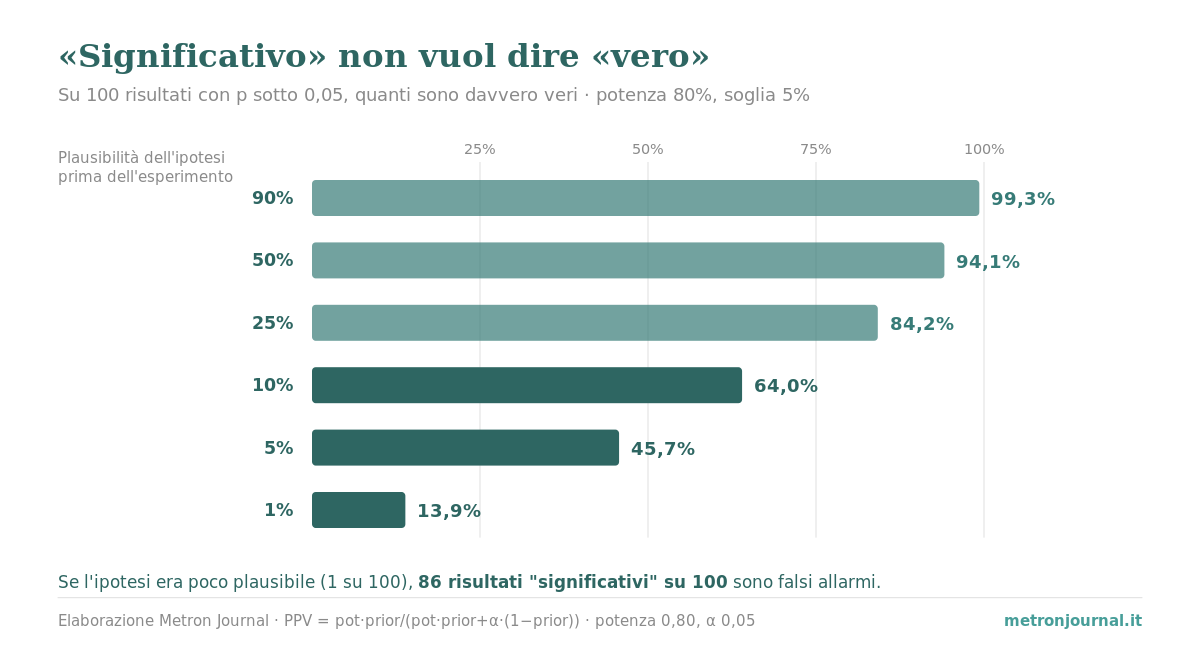
| Plausibilità dell’ipotesi (prior) | Quota di risultati significativi che è davvero vera |
|---|---|
| 90% | 99,3% |
| 50% | 94,1% |
| 25% | 84,2% |
| 10% | 64,0% |
| 5% | 45,7% |
| 1% | 13,9% |
Potenza 80%, α 5%. Elaborazione Metron Journal. Il valore predittivo positivo è calcolato con la regola di Bayes: PPV = potenza·prior / (potenza·prior + α·(1−prior)).
Quando l’ipotesi è a priori poco plausibile — una su cento, il caso tipico della «pesca» esplorativa che prova mille idee sperando di azzeccarne una — un risultato significativo è vero solo nel 14% dei casi: 86 volte su 100 è un falso allarme. Il p-value non è cambiato; è cambiato quello che ci mettevi intorno. È il motivo per cui una scoperta sorprendente e isolata va presa con cautela, e una conferma di qualcosa di già plausibile è molto più solida: non perché il p sia diverso, ma perché il prior lo è.
Un secondo fattore peggiora il quadro: la potenza bassa. Se il test ha poca capacità di rilevare un effetto vero (campioni piccoli, effetti deboli), tra i pochi risultati significativi che escono cresce la quota di falsi. Con lo stesso prior del 10%, passando da una potenza dell’80% a una del 20% la quota di veri fra i significativi (sempre nel modello) scende dal 64% al 31%. È il meccanismo su cui poggia la tesi di uno dei lavori più citati della metascienza, quello di John Ioannidis del 2005 dal titolo volutamente provocatorio «Why Most Published Research Findings Are False»: Ioannidis argomenta che, quando si combinano ipotesi poco plausibili, potenza bassa, molti gruppi in competizione e margini di scelta nell’analisi, la maggioranza delle scoperte pubblicate in interi campi può risultare falsa. È una conclusione condizionata a quelle assunzioni, non un fatto misurato valido per tutta la ricerca — ma indica bene la direzione in cui base rate e potenza spingono.
Testa venti cose e ne trovi una «per caso»
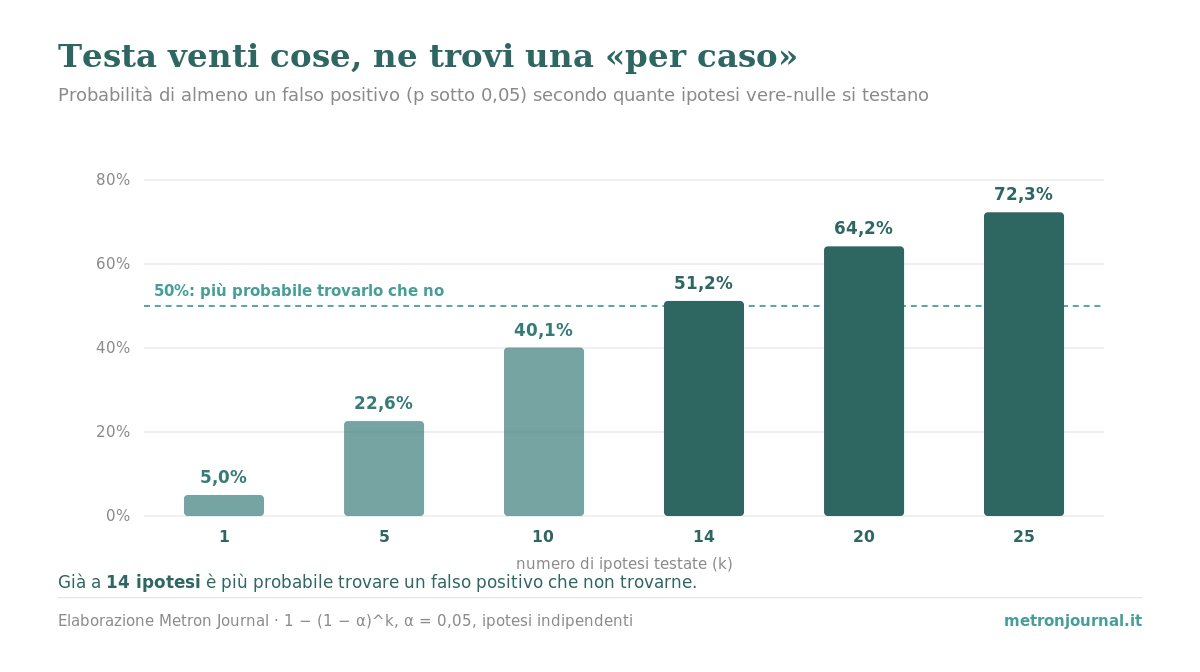
C’è un’ultima trappola, la più insidiosa perché è invisibile nel numero finale. Se l’ipotesi nulla è vera, un test dà un falso positivo il 5% delle volte. Ma se di test ne fai venti, la probabilità di beccare almeno un falso positivo non è più il 5%: è molto di più.
| Ipotesi testate (k) | Probabilità di almeno un falso positivo |
|---|---|
| 1 | 5,0% |
| 5 | 22,6% |
| 10 | 40,1% |
| 14 | 51,2% |
| 20 | 64,2% |
| 25 | 72,3% |
Ipotesi vere-nulle indipendenti, α 5%. Probabilità = 1 − (1 − 0,05)^k. Elaborazione Metron Journal.
Già a quattordici ipotesi testate — se nessuna delle ipotesi è vera e i test sono indipendenti — è più probabile trovare un falso positivo che non trovarne. Questo è il meccanismo dietro il p-hacking: se provi molte varianti — molte sottopopolazioni, molte misure, molte soglie — e poi racconti solo quella che è «venuta significativa», hai quasi la garanzia di trovare qualcosa, anche quando non c’è niente. Il rimedio esiste (dichiarare in anticipo quante e quali analisi si faranno, correggere per il numero di test), ma la difesa vera è la trasparenza: sapere quante cose sono state provate prima di quella che ti raccontano.
Cosa dice l’ASA, in sei righe
Nel 2016 l’American Statistical Association — la principale associazione di statistici al mondo — ha pubblicato un comunicato ufficiale proprio per fermare gli abusi. I suoi sei principi, in sintesi:
- Il p-value può indicare quanto i dati sono incompatibili con un modello statistico specificato.
- Il p-value non misura la probabilità che l’ipotesi studiata sia vera, né la probabilità che i dati siano frutto del solo caso.
- Le conclusioni scientifiche e le decisioni non dovrebbero basarsi solo sul fatto che un p-value superi una soglia.
- Un’inferenza corretta richiede trasparenza e resoconto completo (comprese tutte le analisi tentate).
- Un p-value non misura la dimensione di un effetto né la sua importanza.
- Da solo, un p-value non fornisce una buona misura dell’evidenza a favore di un’ipotesi.
Nel 2019 la stessa associazione è tornata sul tema con un editoriale ancora più netto, che invita ad andare «oltre p < 0,05»: non un divieto del p-value, ma la fine dell’idea che una soglia possa sostituire il ragionamento. La raccomandazione pratica è affiancare sempre al p-value la dimensione dell’effetto e un intervallo di confidenza, che dice non solo «c’è qualcosa» ma «quanto», e con quale incertezza.
La morale è quella di sempre su questo sito: un numero da solo — anche un p-value — non decide niente. Dice quanto i dati sarebbero sorprendenti se non ci fosse alcun effetto. È un pezzo dell’indagine, non il verdetto.
Su questo sito: l’altra faccia dell’incertezza, quella che l’ASA consiglia di preferire, è l’intervallo di confidenza; perché «significativo» non vuol dire né «importante» né «causa» lo spieghiamo in Correlazione non è causazione; e la statistica di test da cui esce il p-value nasce dalla deviazione standard; e sei correlazioni «significative al 5%» che non significano niente sono in correlazioni spurie: una raccolta italiana. E la stessa regola di Bayes, applicata ai test invece che agli studi, spiega perché un test positivo può ingannare in falsi positivi.
Domande frequenti
Che cosa misura esattamente un p-value?
Il p-value è la probabilità, calcolata assumendo vera l’ipotesi nulla (nessun effetto), di osservare un risultato uguale o più estremo di quello ottenuto. Misura la compatibilità tra i dati e l’ipotesi nulla: più è piccolo, più i dati sarebbero sorprendenti se non ci fosse alcun effetto. Non misura la probabilità che l’ipotesi sia vera, perché quella verità è data per scontata nel calcolo.
«Statisticamente significativo» vuol dire che l’effetto è vero?
No. Significa solo che il p-value è sceso sotto una soglia convenzionale, di solito 0,05. Non dice che l’effetto è reale, né che è grande, né che è importante. Un risultato significativo può essere un falso allarme, soprattutto se l’ipotesi di partenza era poco plausibile o il test aveva poca potenza: in questi casi la maggioranza dei risultati significativi può essere falsa.
Perché la soglia è 0,05?
È una convenzione proposta da Ronald Fisher negli anni Venti: un risultato su venti come livello comodo di attenzione. Non ha nulla di speciale dal punto di vista matematico. L’American Statistical Association, nel 2016 e nel 2019, ha invitato esplicitamente a non far dipendere le conclusioni dal semplice superamento di una soglia.
Un p-value di 0,03 significa che c’è il 97% di probabilità che l’effetto sia reale?
No, è l’errore più comune. Il p-value non è la probabilità che l’ipotesi sia vera: risponde alla domanda inversa. Per sapere quanto è probabile che un effetto sia reale dopo aver visto i dati serve anche quanto era plausibile prima (il base rate), un’informazione che il p-value da solo non contiene.
Cosa vuol dire p-hacking?
È la pratica, consapevole o no, di provare molte analisi diverse e riportare solo quella «venuta significativa». Testando molte ipotesi la probabilità di trovare almeno un falso positivo cresce in fretta: con quattordici test è già più probabile trovarne uno che non trovarne. La difesa è la trasparenza: dichiarare in anticipo le analisi previste e sapere quante cose sono state provate.
Fonti
- American Statistical Association — «Statement on Statistical Significance and P-Values» (R. L. Wasserstein, N. A. Lazar), The American Statistician, 70(2), 129–133, 2016. I sei principi e la definizione ufficiale del p-value. Testo ufficiale ASA (PDF): amstat.org · DOI 10.1080/00031305.2016.1154108.
- American Statistical Association — «Moving to a World Beyond p < 0.05» (R. L. Wasserstein, A. L. Schirm, N. A. Lazar), editoriale, The American Statistician, 73(sup1), 1–19, 2019 (accesso aperto). L’invito a non far decidere la soglia. DOI 10.1080/00031305.2019.1583913.
- J. P. A. Ioannidis — «Why Most Published Research Findings Are False», PLoS Medicine, 2(8), e124, 2005. Il quadro base rate / potenza qui usato in forma semplificata. journals.plos.org
- Elaborazione Metron Journal. Valore predittivo positivo e probabilità di falso positivo con test multipli, calcolati in
dati_pvalue.py(PPV = potenza·prior/(potenza·prior+α·(1−prior)); 1−(1−α)^k). Serie PPV per tre potenze scaricabile in CSV.
Falsi positivi: perché un test affidabile al 99% può ingannare