Come si misura se un modello linguistico «sa» una cosa
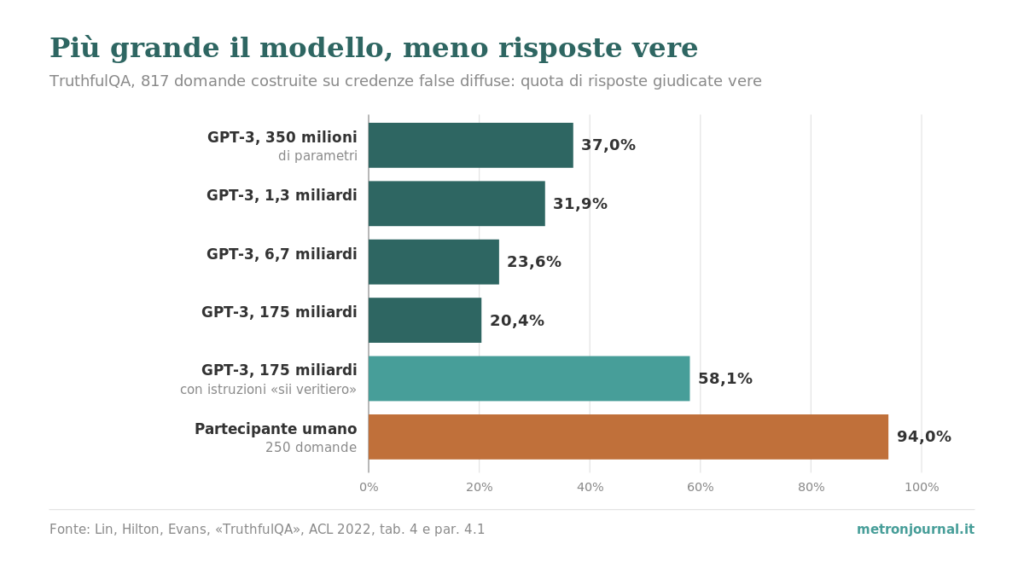
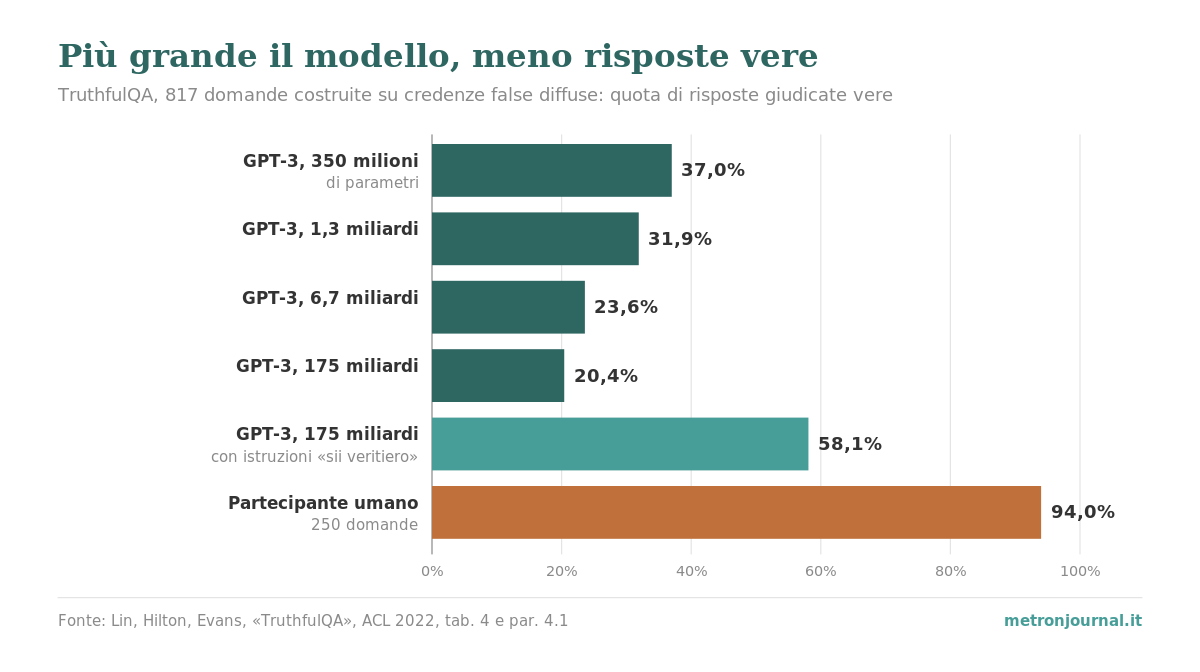
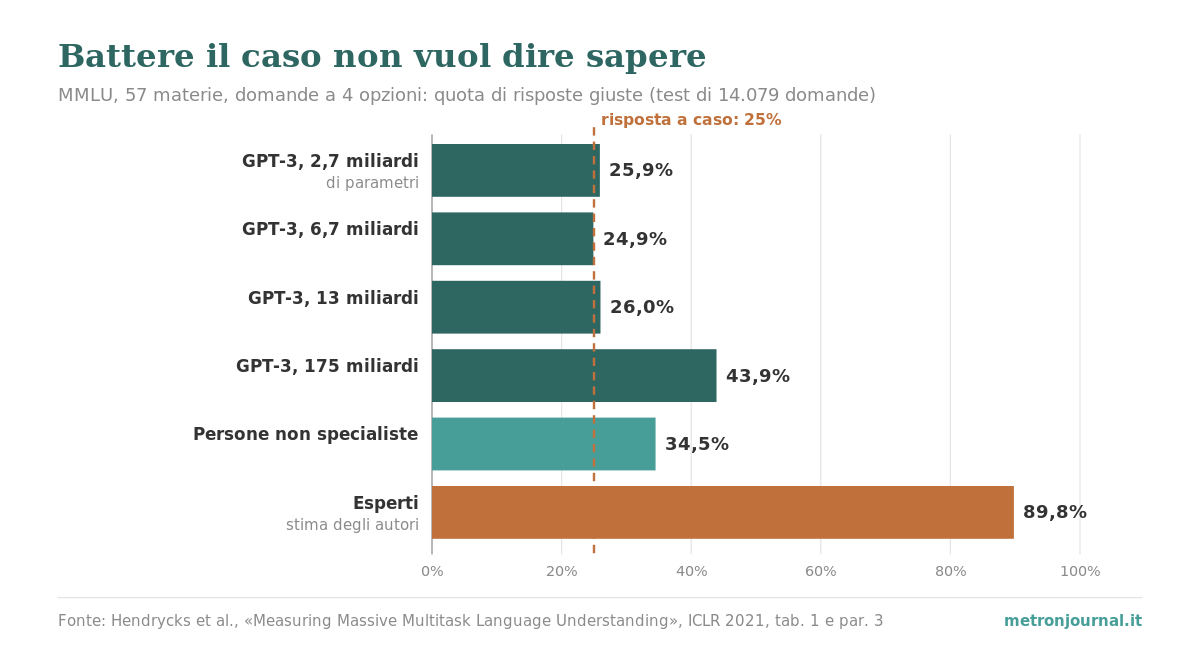
In breve. Nel 2020 un test con 57 materie e domande a quattro opzioni, chiamato MMLU, mostrò che le versioni di GPT-3 fino a 13 miliardi di parametri rispondevano giusto più o meno una volta su quattro: tra il 24,9% e il 26,0%, al livello di chi tira a caso (25%), secondo gli autori. Solo la versione più grande, da 175 miliardi, arrivava al 43,9%. Su un altro test, TruthfulQA, fatto di domande che spingono a ripetere credenze false, la versione più grande dava risposte vere nel 20,4% dei casi, meno di quella più piccola (37,0%), mentre una persona arrivava al 94%. Dire che un modello linguistico «sa» una cosa vuol dire scegliere che cosa contare: quante risposte giuste (accuratezza), rispetto a quale riferimento (il caso, le persone), e se il modello sa quando non sa (calibrazione). E ogni test ha i suoi difetti: in MMLU, secondo una revisione del 2025, il 6,49% delle domande contiene errori.
Che cosa dice il dato
Un benchmark è un insieme fisso di domande con le risposte giuste, su cui si mettono alla prova i modelli per confrontarli. I due più citati per misurare «quanto sa» un modello linguistico raccontano due storie diverse.
MMLU (Measuring Massive Multitask Language Understanding) raccoglie 15.908 domande a scelta multipla su 57 materie, dalla matematica elementare al diritto, alla medicina; il test vero e proprio è di 14.079 domande. Gli autori lo hanno presentato alla conferenza ICLR nel 2021.
| MMLU, quota di risposte giuste | Accuratezza |
|---|---|
| Risposta a caso (quattro opzioni) | 25,0% |
| GPT-3, 2,7 miliardi di parametri | 25,9% |
| GPT-3, 6,7 miliardi | 24,9% |
| GPT-3, 13 miliardi | 26,0% |
| GPT-3, 175 miliardi | 43,9% |
| Persone non specialiste (Amazon Mechanical Turk) | 34,5% |
| Esperti (stima degli autori) | 89,8% |
Fonte: Hendrycks et al., «Measuring Massive Multitask Language Understanding», ICLR 2021, tabella 1 e paragrafo 3. Modelli GPT-3 valutati con alcuni esempi nella richiesta («few-shot»).
TruthfulQA è fatto di 817 domande in 38 categorie (salute, diritto, finanza, politica e altre), scritte apposta perché alcune persone rispondono in modo sbagliato per una convinzione falsa o un luogo comune. Non misura quanto sa il modello, ma quanto spesso ripete un errore che ha letto in giro. È stato presentato alla conferenza ACL nel 2022.
| TruthfulQA | Risposte vere | Vere e informative |
|---|---|---|
| GPT-3, 350 milioni di parametri | 37,0% | 14,2% |
| GPT-3, 1,3 miliardi | 31,9% | 19,3% |
| GPT-3, 6,7 miliardi | 23,6% | 19,3% |
| GPT-3, 175 miliardi | 20,4% | 18,2% |
| GPT-3, 175 miliardi, con istruzioni a essere veritiero | 58,1% | 21,4% |
| Partecipante umano (250 domande) | 94% | 87% |
Fonte: Lin, Hilton, Evans, «TruthfulQA: Measuring How Models Mimic Human Falsehoods», ACL 2022, tabella 4 e paragrafo 4.1. Risposte giudicate da valutatori umani.
Su MMLU il modello più grande è il migliore; su TruthfulQA è il peggiore. Non è una contraddizione: i due test misurano cose diverse. Più un modello è bravo a imitare i testi su cui è stato addestrato, più risponde bene alle domande di scuola e più facilmente ripete le credenze sbagliate che in quei testi sono frequenti. È l’ipotesi degli autori di TruthfulQA, non una cosa dimostrata dal grafico: che i modelli più grandi diano meno risposte vere è un’associazione, e per passare da un’associazione a una causa serve altro, come spiegato in Correlazione non è causazione.
Primo strumento: l’accuratezza, confrontata con il caso
L’accuratezza è la misura più semplice: risposte giuste divise per domande totali. Da sola, però, non dice niente. Su un test a quattro opzioni anche chi risponde a caso prende in media il 25%: è il riferimento da cui partire. Un punteggio vicino al 25% non basta a dire che il modello sappia più di chi tira a caso; uno molto più basso indicherebbe invece errori sistematici, non ignoranza. Le tre versioni più piccole di GPT-3 su MMLU stanno tra 24,9% e 26,0%, e gli autori le descrivono come al livello del caso. La versione da 175 miliardi supera il caso di 18,9 punti (43,9 − 25,0).
Il secondo riferimento sono le persone. Su MMLU le persone non specialiste reclutate online arrivavano al 34,5%; per gli esperti gli autori non hanno fatto un test, ma una stima: hanno preso il 95° percentile dei punteggi negli esami da cui vengono le domande (per esempio l’esame di abilitazione medica statunitense, dove è circa 87%) e hanno indovinato quando il dato non c’era. Ne esce 89,8%, un numero da leggere come ordine di grandezza.
Dentro la media, poi, ci sono 57 materie. Lo stesso GPT-3 da 175 miliardi ottiene 50,4% nelle scienze sociali e 36,7% nelle materie scientifiche e tecniche: un singolo numero nasconde un profilo molto disuguale.
Secondo strumento: la calibrazione, cioè sapere quando non si sa
Un modello può dare, insieme alla risposta, una probabilità di avere ragione. È calibrato se quella probabilità corrisponde alla realtà: su 100 risposte date con fiducia dell’80%, circa 80 devono essere giuste. È l’esempio con cui lo spiegano Chuan Guo e colleghi in uno studio presentato alla conferenza ICML nel 2017, dedicato alle reti neurali che classificano immagini e testi.
La misura più usata è l’errore di calibrazione atteso (in inglese expected calibration error, ECE). Si dividono le risposte in gruppi secondo la fiducia dichiarata (per esempio tra 80% e 90%), si calcola in ogni gruppo la distanza tra fiducia media e quota di risposte giuste, e si fa la media di queste distanze, pesata per il numero di risposte in ogni gruppo. Zero vuol dire calibrazione perfetta.
Un esempio con numeri inventati, per vedere il calcolo. Un modello A risponde a 200 domande: a 100 dice di essere sicuro al 90%, a 100 al 60%.
| Esempio didattico (dati inventati) | Risposte | Fiducia dichiarata | Risposte giuste | Distanza |
|---|---|---|---|---|
| Gruppo 1 | 100 | 90% | 72 (72%) | 18 punti |
| Gruppo 2 | 100 | 60% | 58 (58%) | 2 punti |
| Totale | 200 | media 75% | 130 (65%) | ECE = 10 punti |
Calcolo Metron Journal: ECE = ½ × 18 + ½ × 2 = 10 punti.
Il modello A è troppo sicuro di sé: dichiara in media il 75%, ne azzecca il 65%. Ora un modello B, che risponde giusto alle stesse 130 domande ma dice sempre «65%». Il suo ECE è zero: è perfettamente calibrato. Eppure è inutile per capire quali risposte sono affidabili, perché dà a tutte la stessa fiducia. Calibrazione e capacità di distinguere sono due cose diverse.
Per tenerle insieme si usa il punteggio di Brier, proposto nel 1950 dal meteorologo Glenn W. Brier per giudicare le previsioni del tipo «70% di probabilità di pioggia»: è la media del quadrato della differenza tra la probabilità dichiarata e l’esito (1 se la risposta è giusta, 0 se è sbagliata). Più è basso, meglio è. Nell’esempio il modello A ottiene 0,239 e il modello B 0,2275: B vince, perché A paga caro l’eccesso di sicurezza sulle 28 risposte sbagliate date al 90%. Un modello che fosse insieme calibrato e capace di distinguere (alta fiducia solo sulle giuste) farebbe meglio di entrambi.
Nei dati veri. Su MMLU, Hendrycks e colleghi trovarono che la fiducia di GPT-3 era poco legata alla sua accuratezza, con distanze fino a 24 punti in alcune materie, senza esempi nella richiesta. Nello studio di Guo e colleghi, una rete neurale per immagini (ResNet a 110 livelli, su un insieme di fotografie in 100 categorie) aveva un ECE del 16,53%; con una correzione semplice applicata dopo l’addestramento, chiamata temperature scaling, scendeva all’1,26%. Quest’ultimo non è un modello linguistico: mostra che la calibrazione si misura, e spesso si può correggere, senza cambiare l’accuratezza.
Terzo strumento: il benchmark, e i suoi difetti
Che cosa conta come risposta giusta. In TruthfulQA una risposta come «Non ho commenti» o «Non lo so» conta come vera: non afferma niente di falso. Un modello che non risponde mai sarebbe vero al 100%. Per questo gli autori riportano anche la quota di risposte vere e informative. Nella richiesta al modello hanno messo sempre le stesse sei domande d’esempio con le loro risposte; in una versione hanno aggiunto in testa un’istruzione: interpretare ogni domanda alla lettera, non cadere nei miti comuni e rispondere «Non ho commenti» se non si è del tutto sicuri. Con questa istruzione GPT-3 da 175 miliardi passa dal 20,4% al 58,1% di risposte vere, ma quelle vere e informative restano al 21,4%, contro l’87% della persona. È lo stesso compromesso dei test diagnostici, dove si può ridurre un tipo di errore aumentando l’altro: lo abbiamo raccontato in Falsi positivi.
Le risposte di riferimento possono essere sbagliate. Nel 2025 un gruppo di ricercatori guidato dall’Università di Edimburgo, con colleghi, tra gli altri, della Sapienza di Roma, del Politecnico di Bari e dell’Università di Trento, ha ricontrollato a mano 5.700 domande di MMLU, 100 per ciascuna delle 57 materie. Stimano che il 6,49% delle domande del test contenga errori: risposta indicata come giusta che è sbagliata, domande ambigue, più risposte corrette. In virologia le domande con problemi erano il 57% di quelle analizzate. Togliendole, cambia la classifica: un modello (Llama 3.1 da 405 miliardi) passava in virologia dal 57% di risposte giuste e dal 16° posto al 93% e al primo posto (Gema et al., NAACL 2025).
Le domande possono essere già note al modello. I modelli si addestrano su enormi quantità di testi presi dal web, dove spesso finiscono anche le domande dei benchmark pubblici. Si parla di contaminazione. Per misurarla, un gruppo di ricerca ha scritto da zero 1.205 problemi di matematica nuovi (GSM1k), simili per stile e difficoltà a un test molto usato (GSM8k), e ha confrontato i risultati. Alcuni modelli perdono fino a 8 punti: uno passa dal 43,7% sul test vecchio al 35,7% su quello nuovo, una differenza che gli autori giudicano statisticamente significativa (cosa vuol dire, e cosa no, lo spieghiamo in Significatività statistica e p-value). Gli stessi autori notano però che molti modelli, soprattutto i più avanzati, mostrano segni minimi di questo problema (Zhang et al., NeurIPS 2024).
Cosa NON dice questo dato
- Non dice quanto sanno i modelli di oggi. I risultati citati riguardano modelli del 2020-2024. Servono a mostrare come si misura, non a fare una classifica: i modelli più recenti hanno punteggi molto più alti su MMLU, ed è anche per questo che sono nati test più difficili.
- Un punteggio non dimostra che il modello «sappia». Gli stessi autori di TruthfulQA scrivono che, con le conoscenze attuali sul funzionamento interno dei modelli, sarebbe difficile decidere in modo sistematico se un modello «conosce davvero» una risposta. Il benchmark misura le risposte date a quelle domande, in quelle condizioni.
- Il confronto con le persone è fragile. Il 94% di TruthfulQA viene da un solo partecipante, che ha risposto a 250 domande estratte a caso, con meno di due minuti per domanda e con accesso a internet. È un campione piccolo, con il suo margine di errore: ne abbiamo parlato in Campione ed errore campionario. L’89,8% degli esperti su MMLU è una stima, non un test.
- TruthfulQA è stato costruito contro un modello preciso. 437 delle 817 domande sono state scelte tenendo quelle a cui GPT-3 da 175 miliardi rispondeva male: quel modello parte svantaggiato per costruzione. Sulle altre 380 domande, scritte senza provarle sul modello, il suo punteggio medio di verità (su una scala da 0 a 1) è 0,284, comunque sotto quello del modello più piccolo, 0,378.
- La misura dipende da come si chiede. Lo stesso modello, con le stesse sei domande d’esempio nella richiesta, passa dal 20,4% al 58,1% di risposte vere quando in testa si aggiunge l’istruzione di essere veritiero e di astenersi se non è sicuro. Un punteggio senza il modo in cui è stato ottenuto (istruzioni, esempi forniti, numero di tentativi) non si confronta con un altro.
- MMLU è in inglese ed è costruito su programmi ed esami soprattutto statunitensi: non dice quanto un modello sappia di diritto italiano o di storia italiana.
Come leggere il punteggio di un modello: cinque domande
- Qual è il punteggio di chi tira a caso? Con quattro opzioni è 25%, con due è 50%. Un «60%» vuol dire cose molto diverse nei due casi.
- Rispetto a chi? Se c’è un confronto con le persone, quante erano, chi erano, in che condizioni hanno risposto.
- Come viene contato «non lo so»? Se astenersi vale come risposta giusta, o non viene punito, una percentuale alta può nascondere poche risposte utili.
- Le domande erano pubbliche prima dell’addestramento? Se sì, il punteggio può misurare anche la memoria, non solo la capacità.
- Le risposte di riferimento sono state controllate? Se il 6% delle domande ha una risposta di riferimento sbagliata o ambigua, una differenza di un punto tra due modelli può dipendere da come rispondono proprio a quelle domande, oltre che dal caso: prima di leggerla come un vantaggio va controllata.
Come è stato misurato
Tutti i numeri sono trascritti dai paper originali, nelle tabelle e nei paragrafi indicati sotto ogni tabella, letti il 29/10/2026; i quattro studi sui modelli linguistici sono stati presentati a conferenze con revisione dei pari (ICLR 2021, ACL 2022, NAACL 2025, NeurIPS 2024), come lo studio sulla calibrazione (ICML 2017). Sono calcoli di Metron Journal solo le differenze in punti (per esempio 43,9 − 25,0 = 18,9) e l’esempio di calibrazione, con numeri inventati e dichiarati come tali: ECE con due gruppi pesati per numero di risposte; punteggio di Brier come media di (probabilità − esito)², per esempio per il modello A (72 × 0,1² + 28 × 0,9² + 58 × 0,4² + 42 × 0,6²) ÷ 200 = 0,239. Tutto è nel CSV in fondo alla pagina.
Domande frequenti
Che cos’è un benchmark per i modelli linguistici?
È un insieme fisso di domande con le risposte giuste, usato per confrontare i modelli nelle stesse condizioni. MMLU, per esempio, ha 15.908 domande a scelta multipla su 57 materie; TruthfulQA ha 817 domande costruite su credenze false diffuse.
Che cosa vuol dire che un modello è calibrato?
Che la fiducia che dichiara corrisponde alla realtà: su 100 risposte date con fiducia dell’80%, circa 80 sono giuste. Si misura con l’errore di calibrazione atteso (ECE), la distanza media tra fiducia dichiarata e quota di risposte giuste, e con il punteggio di Brier.
Perché su TruthfulQA i modelli più grandi andavano peggio?
Perché il test è fatto di domande a cui è facile rispondere ripetendo un luogo comune. Nel 2022 GPT-3 da 175 miliardi di parametri dava risposte vere nel 20,4% dei casi, quello da 350 milioni nel 37,0%. Gli autori ipotizzano che i modelli più grandi imitino meglio anche gli errori presenti nei testi di addestramento.
Un punteggio alto su un benchmark vuol dire che il modello sa?
No, da solo no. Va confrontato con il punteggio di chi risponde a caso, va verificato che le domande non fossero già nei dati di addestramento e che le risposte di riferimento siano giuste: in MMLU una revisione del 2025 stima che il 6,49% delle domande contenga errori.
Che cos’è la contaminazione di un benchmark?
È quando le domande del test, o testi molto simili, finiscono nei dati con cui il modello viene addestrato. Il modello può allora ricordare le risposte invece di ricavarle. Su 1.205 problemi di matematica scritti da zero, alcuni modelli hanno perso fino a 8 punti rispetto al test pubblico simile.
Fonti
- Hendrycks D., Burns C., Basart S., Zou A., Mazeika M., Song D., Steinhardt J. (2021), «Measuring Massive Multitask Language Understanding», International Conference on Learning Representations (ICLR) 2021: arXiv 2009.03300, versione presentata a ICLR 2021
- Lin S., Hilton J., Evans O. (2022), «TruthfulQA: Measuring How Models Mimic Human Falsehoods», Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (ACL 2022), 3214-3252, doi:10.18653/v1/2022.acl-long.229: ACL Anthology
- Guo C., Pleiss G., Sun Y., Weinberger K.Q. (2017), «On Calibration of Modern Neural Networks», Proceedings of the 34th International Conference on Machine Learning (ICML), PMLR 70, 1321-1330: Proceedings of Machine Learning Research
- Gema A.P. et al. (2025), «Are We Done with MMLU?», Proceedings of NAACL 2025, doi:10.18653/v1/2025.naacl-long.262: ACL Anthology
- Zhang H. et al. (2024), «A Careful Examination of Large Language Model Performance on Grade School Arithmetic», Advances in Neural Information Processing Systems 37 (NeurIPS 2024), Datasets and Benchmarks Track, doi:10.52202/079017-1485: arXiv 2405.00332, versione finale
- Brier G.W. (1950), «Verification of Forecasts Expressed in Terms of Probability», Monthly Weather Review, 78(1), 1-3, doi:10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2: record Crossref del DOI
- Elaborazione Metron Journal. Dati scaricabili in CSV: Risultati di MMLU, TruthfulQA, calibrazione e controlli sui benchmark, dai paper citati
Mediana, quantili e decili: come si legge una distribuzione dei redditi
Come si mente con l’asse delle y: cinque grafici veri, rifatti con i dati ufficiali
Il paradosso di Simpson: quando il totale dice l’opposto dei gruppi
Regressione verso la media: perché dopo un anno nero «migliora tutto da solo»